黑芝麻智能:十年磨一”芯”,重构端侧AI算力版图
十年前,中国智能汽车产业刚刚起步,全产业链基础薄弱,尤其是最核心的智能计算芯片环节,几乎完全依赖进口。
正是在这样的产业断层中,黑芝麻智能毅然入局,带着填补国产高阶智驾算力短板的决心,开启了一场持续至今的技术远征。
从自研核心IP起步,到相继推出华山、武当两大系列芯片,短短数年间,黑芝麻智能通过三代产品迭代,迅速成长为全球领先的智能汽车计算芯片供应商之一。
在此基础上,2026年黑芝麻智能进一步提出战略升维——从智能汽车计算芯片供应商向端侧AI推理芯片平台提供商跨越,目标将在汽车芯片上积累的感知、推理与计算能力,逐步复用到机器人、泛端侧AI等更广阔的推理场景。
当下,端侧AI产业浪潮加速到来。从智能汽车到机器人、泛端侧AI等推理场景,黑芝麻智能依托十年积累的算力技术底座,开启一场从车走向万物的能力远征,重构全球端侧AI算力新版图。
回顾过去十年,黑芝麻智能的出色成绩,始于一个关键选择:自研IP。
“所有东西都买过来的话,是没有生命力的。”在黑芝麻智能创始人兼CEO单记章看来。
因此,在2016年公司正式成立后,黑芝麻智能第一件事便是自研NPU、ISP等核心IP。相较于外购IP,这种做法虽然耗时长、成本高、风险大,但一旦成功,却是难以复制的技术壁垒。
而后的事实也证明,黑芝麻智能的这种“慢”,实则是另一种维度的“快”。
得益于自研IP打下的稳固基础,2019年黑芝麻智能首颗车规级智能驾驶芯片一次流片成功,且此后的华山A1000、武当C1200、华山A2000也均是一次性流片成功,短短五年间快速完成了三代产品跃迁。
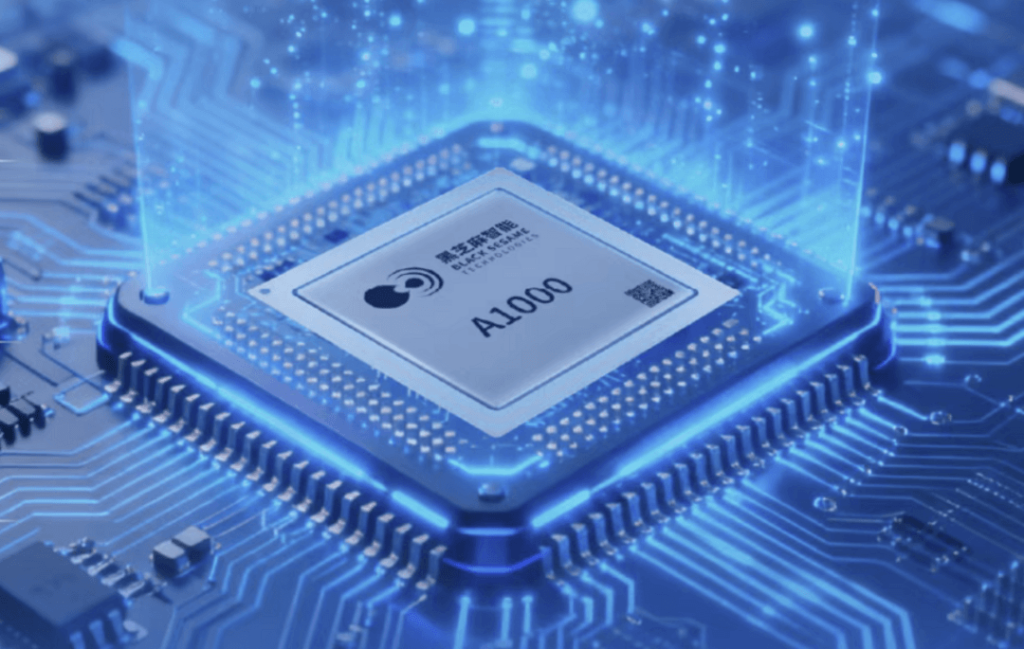
2020年,黑芝麻智能正式发布华山A1000智驾芯片。作为国内首款支持L2/L2+级辅助驾驶的车规级SoC芯片,华山A1000采用了16nm工艺制程,物理算力达58 TOPS,而同期英伟达推出的Xavier系列芯片最高算力为32 TOPS,华山A1000因此成为16nm工艺下算力最强的车规芯片,并且是国内首款同时符合ISO26262 ASIL-B和AEC-Q100 Grade 2的车规芯片。
在此之前,国内智驾芯片市场以外资厂商占据绝对市场份额,而海外供应商的产品不仅价格高昂,在本地化支持和定制化服务方面,也存在明显短板,中国汽车产业迫切需要一颗既能用得上、又用得起的本土智驾芯片。
华山A1000的出现,恰好填补了国产高算力智驾芯片的市场空白,不仅让国内车企第一次拥有了真正可用的本土选择,更用量产事实证明,国产高算力车规芯片这条路,不仅走得通,而且走得稳。
依托成熟可靠的产品力,华山A1000系列芯片先后获得吉利、东风、比亚迪、一汽等多家头部车企定点,落地吉利银河E8/星耀8、领克07/08 EM-P、东风奕派eπ007/eπ008等车型,不仅成为国内生命周期最长的车规级智驾芯片之一,也是车企车型覆盖最广的芯片。
依托华山 A1000 积累的量产实践与市场验证基础,
2023年黑芝麻智能进一步推出行业首个智能汽车跨域计算芯片平台——武当系列,及其首款芯片C1200系列。
作为国内率先实现量产的本土舱驾一体芯片平台,C1200系列最大的亮点是实现了跨域融合架构创新,通过单芯片即可全面覆盖辅助驾驶、智能座舱、车身控制、网关等多个不同功能域的跨域计算需要,支持多样化的人机交互、行泊一体、座舱娱乐、整车数据交互等丰富应用。
在传统分布式架构中,智能座舱、智能驾驶、车身控制和网关等功能由各自独立的ECU分别管控,不仅硬件冗余严重、成本高昂、迭代困难,跨域数据交互的延迟也难以支撑越来越复杂的“座舱-智驾”联动场景。
针对这些痛点,武当C1200基于7nm车规级工艺,通过片内的统一算力调度与高速内存共享,让智能座舱系统与智驾系统得以实现微秒级的数据互通。
今年4月,武当系列迎来量产里程碑,公司与东风达成平台级深度合作,东风天元智舱Plus舱驾一体量产化平台定点武当C1296芯片,单芯片舱驾融合方案率先装车东风奕派007。后续双方将同步推进技术落地,在今明两年覆盖东风旗下多款车型。
值得关注的是,此次黑芝麻智能与东风汽车的平台级合作,也是“首个本土舱驾一体量产芯片+首个本土舱驾一体量产平台”的强强联合,标志着在舱驾融合领域,黑芝麻智能已经成功完成量产卡位。
目前,除了东风汽车,大陆集团、斑马智行、均联智行等也都基于武当芯片推出了高集成度的跨域量产方案。
如果说,华山A1000系列解决了国内在高算力智驾芯片领域“有没有”的问题,武当系列解决了舱驾融合创新架构”好不好”的问题,那么A2000则瞄准的是更广阔的物理AI赛道,旨在进一步推动中国芯片走向世界。
作为黑芝麻智能专为物理AI打造的下一代高算力芯片平台,华山A2000家族共包括四款产品:A2000N、A2000L、A2000U以及旗舰型号A2000X,单芯片算力最高达1000TOPS。该平台既能覆盖座舱AI化到Robotaxi的整车开发需求,还能够广泛应用于机器人大脑、AI BOX本地部署等泛端侧AI领域。
A2000家族搭载了黑芝麻智能自研的九韶NPU架构,从设计之初即针对VLA大模型与世界模型做深度适配,原生支持大规模Transformer加速,旨在成为物理AI时代的通用算力底座。
当前华山A2000芯片已经斩获头部车企定点,覆盖L2+至L3级全场景智能驾驶,即将于今年量产落地,正式迈入商业化应用阶段。
届时,在三代芯片的协同发力下,预计黑芝麻智能今年芯片出货量将远超千万颗。
在汽车业务完成从”跟跑”到”并跑”的跨越之后,黑芝麻智能将目光投向了更广阔的市场。
2025年11月,黑芝麻智能举办“多维进化 智赋新生”机器人平台产品发布会,重磅发布面向全脑智能时代的“SesameX™”多维具身智能计算平台,以及首批机器人合作伙伴名单,正式将业务版图从智能汽车延伸至具身智能机器人领域。
SesameX™是面向全脑智能的机器人商业化部署平台,从硬件、软件、工具链到模型生态,均是由黑芝麻智能全栈自研。平台搭载Kalos、Aura、Liora三款核心模组,构建48-600TOPS的梯度化算力体系,精准匹配从送餐机器人、迎宾机器人等低速轮式机器人,到多足机器人、智能机械臂等,再到具身智能人形机器人的全品类研发需求。
黑芝麻智能为何选择此时切入机器人赛道?答案藏在两重逻辑中。
首先是市场逻辑,具身智能正在成为全球科技产业的下一个竞争高地。
过去两年,大模型技术的突破性进展,将AI从”数字世界的对话者”推向了”物理世界的行动者”。当AI不再局限于生成文字和图像,而是需要理解三维空间、做出实时决策、执行物理动作时,机器人便成了承载这一变革的天然载体。
在SesameX™发布会上,单记章预判,下一个十年,属于“机器人新纪元”,到2030年,预计各种形态的机器人将大量走进人们的日常生活,与人类共同进化;到2040年,各种机器人的年销量预计将突破10亿台,市场规模将达到万亿美元。
其次是技术逻辑,汽车与机器人的底层逻辑高度一致,均为”软件+硬件”复合架构,且均依赖多模态感知与AI推理实现智能化。
这意味着,黑芝麻智能在汽车领域积累的车规级安全体系、异构计算架构、视觉感知能力,恰恰也是具身智能最需要的核心能力,可以系统性复用于机器人场景,形成”一次投入、多场景复用”的乘数效应。
例如黑芝麻智能在辅助驾驶跨域计算里的异构算力,可以为具身智能提供多维度计算支持;其先进的视觉感知技术,包括多摄像头数据融合、动态时空分辨率调节以及低延迟实时处理机制等,同样可以赋予具身智能出色的感知能力。
??????? ? ??????